开源仓库:lgyStoic/colab-ultra
内置 Agent 原生 SKILL.md、物理瓦数断路器、VPS 24h 离线哨兵与多核数据工作流。
AI Agent 算力工程 · Google Colab / GPU & CPU 调度
很多人订阅 Google One AI Ultra 只用 Gemini 和生图生视频,却让账户里附赠的近千个 Colab 算力单元(CU)在后台吃灰,或者因为跑完实验忘关网页白白烧光。我顺手帮 Google 官方 CLI 修了个卡 13.2 秒的认证 Bug(提速 260 倍),并开源了带物理瓦数智能电闸与多核 CPU 数据集群调度的 colab-ultra。
google-colab-cli 在 ADC 认证下每次拉起无用 gcloud 子进程查 project_id 导致卡顿 13.20 秒;补丁将其压到 0.05 秒(快 260 倍)。nvidia-smi 物理功耗(A100/H100 < 75W、T4/L4 < 28W 判为空载),识破 NCCL 死锁 100% 假利用率;超时自动把成果备份回 20TB Google Drive 并断电关机。0.26 CU/h 开出 8 核 AMD EPYC + 51GB 内存节点,支持 5 节点并发组成 40 核 + 255GB 数据清洗集群(仅 1.30 CU/h),或借道 TPU v6e1 宿主机单机拿到 44 核 Zen 4 + 172GB 内存。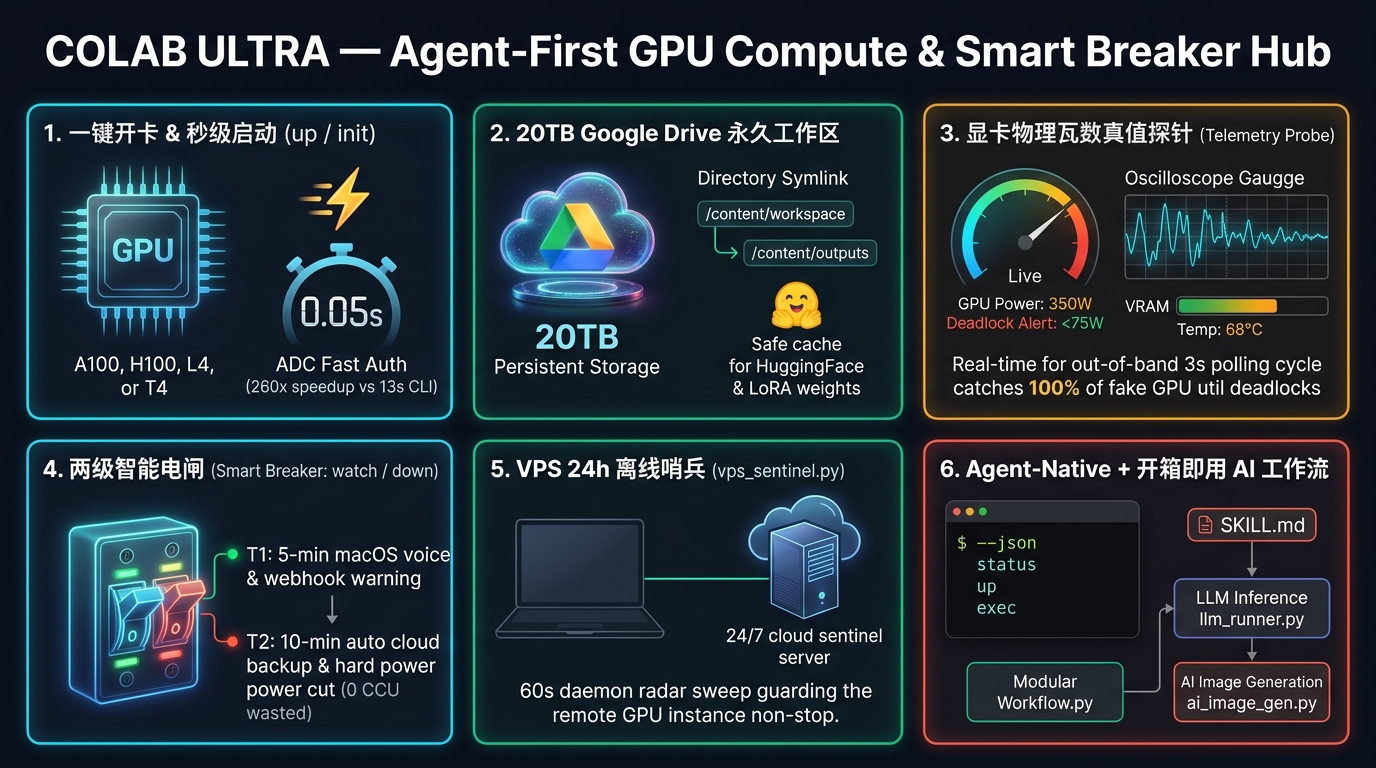
内置 Agent 原生 SKILL.md、物理瓦数断路器、VPS 24h 离线哨兵与多核数据工作流。
修复官方 CLI 在 ADC 认证模式下每次启动耗时 13.2 秒的性能问题。
订阅 Google One AI Ultra 后,除了日常用 Gemini、Deep Research 和 NotebookLM,账号里还附带了 Colab 高级算力权益:直接躺着近 1000 CU(Compute Units,计算单元),并且拥有 NVIDIA A100 80GB、H100 以及多核高内存机器的优先分配通道。
但在实际工程里,我发现主力开发环境(Mac + 本地 Claude Code / Codex / Antigravity 等 AI Agent)和这笔云端算力之间存在三个非常难受的断层:
5.39 CU,两台 A100 加一台 T4 同时开着就是 13.66 CU/h。晚上跑个 15 分钟的脚本忘了手动点断开,机器就以 42W 空载待机挂一整夜,一觉醒来几十个 CU 白白打水漂。nvidia-smi 的百分比利用率经常卡在 100%,但实际上显卡根本没在做矩阵运算,纯粹在空转烧钱。Google 前不久开源了官方命令行工具 google-colab-cli(colab)。我本以为可以直接把它交给本地 AI Agent 调算力,结果上手就撞上一堵墙:在无人值守的 --auth=adc(Application Default Credentials,应用默认凭据)模式下,哪怕跑一条最简单的命令,每次都要死死卡住 13.20 秒。
我用 cProfile 扒了一下官方 CLI 的源码,定位到了一个哭笑不得的原因。在官方仓库的 src/colab_cli/auth.py 里,读取凭据的代码只有一行:
creds, _ = google.auth.default(scopes=COLAB_SCOPES)注意看那个下划线 _——Colab CLI 根本不需要 Google Cloud 的 project_id,它拿到返回值后直接就丢进了垃圾桶。
然而,google-auth 库内部有一个默认逻辑:只要调用 google.auth.default(),它就非要去查出当前机器的 project_id。当本地环境变量没设这个值时,它会在后台偷偷拉起一个完整的 gcloud config get-value project 子进程去扫本地配置并探测元数据服务——整整 13.15 秒,全都浪费在查找一个立刻被丢弃的变量 _ 上。
定位清楚后,修法极其干净:在调用 google.auth.default() 前后用上下文管理器临时注入一个内存占位符,用完立刻还原环境变量:
@contextlib.contextmanager
def _suppress_adc_project_lookup():
    env_keys = ("GOOGLE_CLOUD_PROJECT", "GCLOUD_PROJECT", "CLOUDSDK_CORE_PROJECT")
    if any(os.environ.get(k) for k in env_keys):
        yield
        return
    os.environ["GOOGLE_CLOUD_PROJECT"] = "colab-cli-adc"
    try:
        yield
    finally:
        os.environ.pop("GOOGLE_CLOUD_PROJECT", None)
实测修改前后的耗时对比:
13.20 秒0.05 秒(提速 260 倍)这个补丁我已经提交给 Google 官方仓库(PR #218),同时内置在 colab-ultra init 中自动生效。
解决了底层 13 秒卡顿后,我把官方 CLI 缺失的硬件遥测、防爆仓断路器、20TB Google Drive 永久工作区自动挂载、多节点 CPU 数据集群封装成了开源项目 colab-ultra。
| 能力维度 | 官方 google-colab-cli (v0.7.5) | colab-ultra (本项目) |
|---|---|---|
| 空载与死锁识别 | 无硬件监控,只能查账号总余额 | 实时读取显卡物理瓦数(W)与 CPU 负载:识破 NCCL 100% 假忙(A100/H100 < 75W、T4/L4 < 28W 判为空载) |
| 防忘关机自动拉闸 | 无自动关机,合上电脑即持续扣费 | 5 分钟低负载语音/通知预警 + 10 分钟自动抢救成果至云盘并断电(支持本机 + VPS 24h 离线哨兵) |
| 启动速度与云盘工作区 | ADC 模式每次卡 13.2s,手动挂载繁琐 | 0.05s 极速启动,开机默认挂载 Google Drive 并软链 /content/workspace 与 /content/outputs |
| AI Agent 原生接入 | 面向人类终端表格,缺少执行后硬件反馈 | 全命令支持 --json(单次调用同时返回代码输出 + 显卡瓦数/显存/CPU 核数/剩余 CU),自带 SKILL.md |
当 A100 真正在跑 FP16/BF16 矩阵乘或微调训练时,显卡主板供电功耗通常在 250W ~ 400W;而当脚本跑完退出、或者因为通信死锁卡住时,哪怕 utilization.gpu 还显示 100%,物理功耗也会立刻跌回 22W ~ 44W 的待机底噪。
colab-ultra 会在每台云端实例里静默注入一个非阻塞探针(/content/.colab_probe.py),每 3 秒采样一次物理瓦数、显存、温度、CPU 负载与云盘剩余空间。一旦连续 10 分钟处于空载瓦数,本机守护进程或远端 Linux VPS 上的 24 小时哨兵(vps_sentinel.py)就会先把 /content/outputs 里的权重和产物备份回 Google Drive,随后强制断开实例,把燃烧率降回 0.00 CU/h。
做大模型数据清洗、Parquet/Arrow 转换、爬虫解析或全量去重时,其实根本不需要烧昂贵的 A100(5.39 CU/h),真正紧缺的是多核 CPU + 超大内存 + 高速云盘读写。
我用 colab-ultra 把账号底下所有非 GPU 档位实测了一遍,整理出下面这张性价比极高的 CPU 算力表,并把它们做成了 colab-ultra up 的原生参数:
| 模式档位 | 一键启动命令 | 实测 CPU 型号与核数 | 实测内存 (RAM) | 本地 SSD | 每小时扣费 | 1000 CU 可跑时长 |
|---|---|---|---|---|---|---|
| 1. 标准 CPU | colab-ultra up --cpu --std-mem |
2 核 (Intel Xeon 2.20GHz) | 12.7 GB | 225.7 GB | 0.08 CU/h |
12,500 小时(约 520 天) |
| 2. 高内存 CPU(默认) | colab-ultra up --cpu |
8 核 (AMD EPYC 7B12) | 51.0 GB | 225.7 GB | 0.26 CU/h |
3,846 小时(比 A100 便宜 20 倍) |
| 3. 5 节点 CPU 并发集群 | colab-ultra up --cpu --workers 5 -s data |
40 核(5 台 × 8 核并发) | 255.0 GB(5 × 51G) | 1.1 TB + 共享云盘 | 1.30 CU/h |
769 小时(共享同一 Google Drive) |
| 4. 44 核超大内存单机 | colab-ultra up --tpu v6e1 -s bigmem |
44 核 (AMD EPYC 9B14 Zen 4) | 172.0 GB | 225.3 GB | 5.09 CU/h |
196 小时(单机需 >100GB 内存任务) |
这里有两个非常实用的工程技巧:
data-1 到 data-5)。因為每台机器开机都会默认挂载同一个 Google Drive,你可以让 5 台机器直接按分片 ID 并行清洗同一个云盘目录里的数据,总成本每小时仅 1.30 CU(不到一台 A100 的四分之一)。colab-ultra up --tpu v6e1,就能分到一台 44 核 AMD EPYC 9B14 + 172GB 内存的宿主机。>= 8%(或 load_1m >= 0.4)或内核处于 BUSY,就判定为数据处理活跃;一旦清洗任务结束、CPU 跌回空载满 10 分钟,同样自动备份成果并关机停费。整套工具零隐私硬编码,所有个人配置(如 VPS 地址、SSH 密钥、告警 Webhook)全部隔离保存在仓库外的 ~/.config/colab-ultra/config.json(权限 600)。
# 1. 安装底层官方 CLI 与依赖
uv tool install google-colab-cli
uv tool run --from google-colab-cli pip install rich websocket-client requests

# 2. 克隆仓库并创建全局命令
git clone https://github.com/lgyStoic/colab-ultra.git
cd colab-ultra
chmod +x colab_ultra/breaker.py
ln -sf "$(pwd)/colab_ultra/breaker.py" ~/.local/bin/colab-ultra

# 3. 一键初始化(自动打上 0.05s 极速启动补丁 + 配置智能电闸)
colab-ultra init

# 4. 按任务类型随时拉起云端算力:
colab-ultra up --cpu -s data                     # 8核 51GB 纯 CPU 数据节点 (0.26 CU/h)
colab-ultra up --cpu --workers 5 -s data         # 5台并发 = 40核 255GB 数据集群 (1.30 CU/h)
colab-ultra up --tpu v6e1 -s bigmem              # 44核 Zen4 + 172GB 超大内存单机 (5.09 CU/h)
colab-ultra up --gpu A100 -s ultra               # A100 80GB 训练/推理节点

# 5. 让 Agent 远程跑脚本并拿回包含硬件遥测的 JSON:
colab-ultra exec -s data -f workflows/cpu_data_pipeline.py --json
colab-ultra exec -s ultra -f workflows/a100_benchmark.py --json

# 6. 任务完成,一键安全备份云盘并清空所有机器(立省 100% 算力):
colab-ultra down --allColab Ultra (lgyStoic/colab-ultra) turns the Compute Units (CU) bundled with a Google One AI Ultra or Colab Pro+ subscription into an autonomous, Agent-First GPU and high-memory CPU backplane for local AI Agents (Claude Code, Codex, Antigravity, Cursor).
While building it, we profiled Google's official google-colab-cli and found that --auth=adc stalled for 13.20 seconds on every invocation because google.auth.default() spawned a redundant gcloud subprocess to resolve a project_id that Colab immediately discarded. Our upstream fix (PR #218) cuts startup latency to 0.05 seconds (a 260x speedup).
On top of the patched CLI, colab-ultra adds an out-of-band physical GPU wattage circuit breaker (detecting idle runtimes and NCCL spin-wait deadlocks via nvidia-smi board power draw), automatic 20TB Google Drive workspace persistence, a 24/7 standalone VPS sentinel daemon, and first-class multi-core CPU / big-memory orchestration—supporting 8-vCPU / 51GB RAM nodes at 0.26 CU/h, 5-node parallel clusters (40 vCPUs / 255GB RAM at 1.30 CU/h), and 44-vCPU AMD EPYC Zen 4 / 172GB RAM single-node hosts via --tpu v6e1.